写在前面的
以前我写机器学习笔记时,往往会直接进入算法本身。但决策树这部分涉及不少基础概念,所以这次我想先把几个核心名词讲清楚。
决策树就是帮你从混乱中做出决策的。学习各种树的过程就是学习决策树本身。
目前要学习以下3个树。
| 算法 | 用什么选特征/切分 | 做什么任务 | 树的形状 |
|---|---|---|---|
| ID3 | 信息增益(Information Gain) | 分类 | 多叉树 |
| C4.5 | 信息增益率(Gain Ratio) | 分类 | 多叉树 |
| CART | 分类看基尼,回归看误差 | 分类 + 回归 | 二叉树 |
1 概念
决策树(Decision Tree)是一种树形结构的监督学习算法,广泛用于分类和回归任务。
它通过分而治之的策略,自根至叶将数据集划分为更纯的子集。树的内部节点代表特征属性测试,分支代表测试输出,叶节点代表最终决策结果。因其白盒模型特性,易于理解、可视化和解释。
它的核心思想非常简单:通过不断地问简单的问题,把范围一步步缩小,最终得到一个确定的答案
大概就是。你今天下班回家,想亲手做顿饭放松一下。但你不确定具体要做什么,你的大脑其实就会自动构建一棵决策树来帮你做决定。你通过问一系列只要回答『是』或『否』的小问题,把一个复杂的大决定(吃什么),拆解成了一步步的路径。比如下面的例子。
第一个问题:今天有充足的时间吗?
- 是 ➡️ 顺着树枝往下走,遇到下一个问题:冰箱里有肉吗?
- 回答『有』 ➡️ 结论:做个耗时的炖肉。
- 回答『没有』 ➡️ 结论:做个精致的素菜。
- 否 (想快点吃上饭) ➡️ 顺着另一根树枝往下走,遇到下一个问题:非常饿吗?
- 回答『是』 ➡️ 结论:快速煮个面条。
- 回答『否』 ➡️ 结论:拌个简单的沙拉。
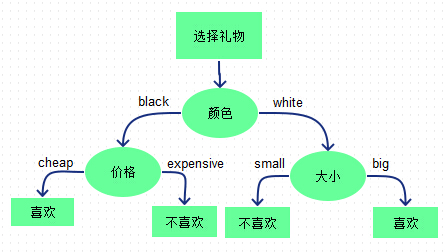
决策树长什么样?
根节点(Root Node): 树的最顶端,也就是你问的第一个也是最关键的问题比如『今天有充足的时间吗?』。
内部节点(Internal Node): 树枝中间的那些后续问题比如『冰箱里有肉吗?』。
叶子节点(Leaf Node): 树的最末端,也就是最终的决定或分类结果比如『煮个面条』。到了叶子这里,问题就问完了,游戏结束。
感觉就是⬇️
2 分类
这里原本写的是学习必备基础,但是后来想一下,其实按照具体的树来看会比较好。利用概念学习具体的树进行计算会学得更快。
- ID3 ➡️ 信息熵 信息增益的概念
- C4.5 ➡️ 信息增益率的概念
- CART树 ➡️ 基尼指数
3 ID3
了解了决策树是什么之后,下一步就是思考:怎样才能把最重要的特征放在根节点上?这样就知道下一步又是什么节点了。
比如对于一些人来说,长得帅就是比有钱重要的多多多!!那我们如何去选择最重要的那个特征第一选择呢?这就需要引入 ID3 中最核心的两个概念:信息熵(Entropy) 和 信息增益(Information Gain)。
3-1 信息熵 Information Entropy
在决策树中,信息熵是用来衡量一个数据集的『混乱度』或『不纯度』的指标。
- 熵越小:数据越纯,越整齐(比如一筐全是苹果,毫无悬念)。
- 熵越大:数据越乱,越难预测(比如一筐里有 5 个苹果、5 个橘子,随便抓一个,你很难确定是什么)。
为什么会出现信息熵?
接着上面的比喻来说。这棵树怎么知道第一个问题应该问『时间充不充足』,而不是问『今天穿了什么颜色的衣服』呢?
这就回到我们『信息熵』了。机器在构建这棵树时,会在每一步挑问题。它挑选的标准就是:哪个问题能让剩下的选项变得最清晰、最不混乱?(也就是让信息熵下降最多)。
因为『今天穿了什么颜色的衣服』对决定晚饭吃什么毫无帮助(信息熵没有下降)。而『时间充不充足』能瞬间帮你排除掉一大半不现实的菜谱,让你的目标变得非常纯净,所以它成了最完美的『根节点』。
那如何计算呢?
计算信息熵步骤
假设我们有一个数据集 D,里面有 c 种不同的类别。第 i 种类别在数据集中所占的比例(概率)是 pi。那么这个数据集的信息熵 H(D) 的公式是
- pi某个类别的概率。
- log代表 以 2 为底的对数。因为 pi 肯定是0-1之间的小数。所以出来的对数必定是负数或 0。
- 前面的负号为了把最终结果变成正数,方便我们比较。
- 把所有类别的 pi 和log2(pi) 算出来后,全部加在一起。
[feature, label]
[a, x]
[b, x]
[b, y]
[c, y]
[c, y]
⚠️ 记住一个很重要的理论,总体的信息熵是对于 标签 的,比如上面,那么就只关注x和y,不关注feature。
⬆️ 什么玩意儿?不会算,那么直接给例子。
假设我们有一个装了 10 个球的盲盒,球只有两种颜色:红色和蓝色。
-
极端情况 1:最混乱的状态(5 红 5 蓝)
- 红球概率 p1 = 5/10 = 0.5 = 1/2
- 蓝球概率 p1 = 5/10 = 0.5 = 1/2
最后结果就是1。结论➡️当两种类别势均力敌(各占 50%)时,混乱度最高,信息熵达到最大值 1。
-
极端情况 2:最纯粹的状态(10 红 0 蓝)
-
红球概率 p1 = 10/10 = 1
-
蓝球概率 p2 = 0/10 = 0
最后结果就是0。当数据里只有一种东西时,没有任何不确定性,信息熵为 0。
-
-
一般情况:偏向某一边(7 红 3 蓝)
- 红球概率 p1 = 7/10 = 0.7
- 蓝球概率 p2 = 3/10 = 0.3
这里就不能口算log了,那么就是计算器计算
最后继续计算
你可以看到,随着红球变多(从 5 个变成 7 个),数据集变得稍微纯了一点,所以信息熵从最大值 1 下降到了 0.8816。
重点1 只是关注label,也就是结果。不关心feature
重点2 计算公式要记牢
3-2 信息增益 Information Gain
如果把『信息熵』比作房间的混乱程度,那么『信息增益』就是你打扫了一次房间后,混乱程度减少了多少。也就是上面我说的
决策树在每一次要分叉(提问)的时候,都会把所有能问的问题在心里默默算一遍,然后挑出一个能让『信息增益』最大(也就是让混乱度下降最多)的问题。接下来就是有点难的公式理解了
我们一般用 D 代表我们要处理的数据集,用 a 代表我们用来分类的某个特征(比如『大小』或『颜色』)
信息增益的正式数学公式是这样的⬇️
依然还是不懂怎么计算的话,就接着看例子。
下面给一个盲盒例子。总共 10 个球:7 个红球,3 个蓝球。大球有 5 个:全是红球(5 红 0 蓝)。小球有 5 个:有红有蓝(2 红 3 蓝)。整理成表格是这样的。
| 编号 (ID) | 属性:大小 (feature) | 结果:颜色 (label) |
|---|---|---|
| 1 | 大 | 红 |
| 2 | 大 | 红 |
| 3 | 大 | 红 |
| 4 | 大 | 红 |
| 5 | 大 | 红 |
| 6 | 小 | 红 |
| 7 | 小 | 红 |
| 8 | 小 | 蓝 |
| 9 | 小 | 蓝 |
| 10 | 小 | 蓝 |
现在我们的计算目的就是
通过『按大小分类』,我们到底获得了多少『信息增益』?
计算信息增益
① 计算分开前的总信息熵(总混乱度)
在没按大小分类前,我们面对的是一堆混在一起的 10 个球。
- 红球概率:p1 = 7/10 = 0.7
- 蓝球概率:p2 = 3/10 = 0.3
我们套用信息熵公式
借助计算器算一下对数。然后代入进去
② 分别计算分开后的子节点信息熵
按大小分开后,变成了两堆球,我们挨个算它们的混乱度。
⚠️ 要注意这里计算的是特征之后的标签哦!!不是只看特征!!!
1. 大球堆(5 个球,5 红 0 蓝)
-
红球概率:p1 = 5/5 = 1
-
蓝球概率:p2 = 0/5 = 0
(合理,完全不乱,混乱度为 0。)
2. 小球堆(5 个球,2 红 3 蓝)
-
红球概率:p1 = 2/5 = 0.4
-
蓝球概率:p2 = 3/5 = 0.6
小球堆里红蓝比例接近一半一半,所以比较混乱,数值接近 1。
③ 计算分开后的『加权平均』信息熵
现在我们有了大球的混乱度(0)和小球的混乱度(0.9710)。因为大球和小球各占了总数的一半(5 个),我们需要按比例把它们加起来。
- 大球堆占总数的权重:5/10 = 0.5
- 小球堆占总数的权重:5/10 = 0.5
按大小分类后,整体的混乱度降到了 0.4855。
④ 计算最终的信息增益
这就是最后一步减法了。
信息增益 = 信息熵 - 分类后的加权信息熵
最终答案: 通过问『球是大的还是小的』,我们把混乱度减少了 0.3958,这就是这个条件带来的信息增益!
拆解公式
为了让这个公式更有通用性,下面把它拆开来理解
公式的左半边:老规矩,算总账
- Gain(D, a):这就是我们要算的最终结果——在数据集 D 上,按属性 a 划分带来的『信息增益』。
- H(D):划分前,整个大盲盒的初始『信息熵』(也就是我们刚才算出来的总混乱度 0.8813 例子:红蓝球7/3)。
公式的右半边:算分家后的加权平均
右边这一大坨 其实就是我们在第三步算的『加权平均混乱度』。
- V:属性 a 分出了几个岔路。比如按『大小』分,只有大和小两路,那么 V = 2。
- v:代表具体的某一条岔路(比如第 1 路是大球,第 2 路是小球)。
- |D|:盲盒里总共的球数(10 个)。
- |D^v|:分家后,跑到第 v 条岔路里的球数(比如大球有 5 个)。
- D^v| / |D|:这就是权重比例(比如 5/10 = 0.5)。
- H(D^v):这条岔路自己内部的『信息熵』(比如大球堆的混乱度 0,小球堆的混乱度 0.9710)。
- sum (求和符号):意思是把每一条岔路的『权重 * 内部混乱度』挨个算出来,然后全部加在一起。
把我们的盲盒例子代入公式
如果把我们刚才算的具体文字替换进这个公式里,它长这样
把数字填进去,
所有的数学符号,最终都落在了这个非常接地气的逻辑上
原先的混乱度,减去按比例算出来的现在的混乱度,就是我赚到的清晰度(信息增益)。
上面这种**用信息增益(Information Gain)**来选择切分特征的决策树方法,就是 ID3 的核心思路。
0.971 - 0.551 = 0.420
0.971 - 0.361 = 0.610 ⬅️ 选这个 因为最后减幅最大
4 C4.5树
只看信息增益会有一个明显问题:它容易偏向那些取值很多的特征。
比如『编号』『身份证号』这类特征,几乎可以把样本切得非常碎,看起来纯度很高,但其实没有泛化能力。
为了修正这个问题,C4.5 引入了 信息增益率(Gain Ratio)。
4-1 ID3弊端
上面说的单纯的计算信息增益的算法是古老的ID3树系列的,到底ID3只看信息熵的弊端在哪里呢?就要理解下面的例子
假设有 4 个周末,我们记录了天气和最终是否去游乐园的数据。
| 日期编号 (特征 A) | 天气 (特征 B) | 是否去游乐园 (标签 / 结果) |
|---|---|---|
| 1 | 晴天 | 去 |
| 2 | 晴天 | 去 |
| 3 | 雨天 | 不去 |
| 4 | 雨天 | 不去 |
在还没有做任何分类前,整体的信息熵(看结果列:2 个去,2 个不去,各占 50%)
因为有2个特征日期编号和天气,那么就分别计算一下信息熵吧。
- 按照天气分类来计算 信息增益
- 晴天堆(2 个数据):全是『去』。这堆的内部信息熵为 0。
- 雨天堆(2 个数据):全是『不去』。这堆的内部信息熵也是 0。
最后的结果就是 信息增益 = 1 - 0 = 1(完美地消除了所有混乱!)
- 按照编号分类来计算 信息增益
那么直接切成了 4 堆(1号、2号、3号、4号堆)。每一堆里面都只有 1 个数据,毫无悬念,纯度极高,每一堆的内部信息熵全都是 0! 最后的结果就是信息增益 = 1 - 0 = 1(跟天气一样,也完美消除了混乱!)
也就是说无论用编号还是天气最后的结果都是一样的,都是很完美的消除了混乱。
因为 ID3 太古老了,它在实际运用中有两个很明显的缺点:
- 极度偏心(就像刚才的编号问题): 它极其偏爱那些『选项特别多』的特征(比如身份证号、日期、产品编号)。它总是误以为切得越碎就越纯,很容易变成一个只会死记硬背的傻瓜。
- 只会做选择题,不会算连续数字: 原始的 ID3 只能处理『分类』的数据(比如大/小、红/蓝、晴天/雨天)。如果你的表格里有一列是连续的小数(比如温度是 36.5度、价格是 99.8 元),ID3 就不知道该从哪里劈开它了。
这种『只记住过去,完全无法预测未来』的现象,在机器学习里有一个赫赫有名的名字,叫做『过拟合』(Overfitting)。
所以就出来了另外一个计算方式,也就是需要信息增益率 Information Gain Ratio来出场了。
4-2 分裂信息 Split Information / IV
首先要说明一下,C4.5树的特征就是用信息增益率去判断。如果你只是想要单纯的去计算信息增益率,那么就是下面的公式。
那么问题来了。上面的分子和分母分别是什么呢?
先看分子,分子其实就是和上面的信息熵。也就是ID3用的,那么主要是分母的Split Information。
这里有一个补充,可能会在很多地方看到分母有不同的公式,但其实是一样的。无论是分裂信息还是IV。其实表示的都是一个意思。
Split Information(分裂信息) 和 IV(Intrinsic Value,固有值) 完全是一码事,它们是同一个概念在不同文献或教材中的不同叫法。
官方原名(Split Information): C4.5 算法的发明者 Ross Quinlan 在他最初发表的论文中,给这个惩罚项起的名字就叫 SplitInfo(分裂信息)。顾名思义,它衡量的是特征把数据集「分裂」开来所产生的信息量大小。
后来的别名(Intrinsic Value / IV): 后来的一些机器学习教材或学者在讲解这个公式时,为了强调这个值是特征「本身自带的、固有的」属性(因为它只看特征自己的分布,完全不看标签分类的结果),就开始用 Intrinsic Value(固有值)来称呼它。
- |D|:数据集的总样本数。
- |Dv|:特征 A 的第 v 个取值所包含的样本数。
- Dv/D:第 v 个分支的样本数占总样本数的比例。
所以上面是1个意思。那么这个分母也就是分裂信息如何计算呢?其实很简单,就是信息熵的计算公式。
因为它们的计算公式一模一样,唯一的区别在于它们在算哪一列数据。
- 信息熵 盯着的是『结果(标签)』。它关心的是最终分出来的类别纯不纯(比如去还是不去)。
- IV 盯着的是『切法(特征本身)』。它关心的是你这一刀下去,把数据切成了多少块、碎不碎。
对着label算就是信息熵,对着feature算就是IV。
接下来有一个例子你可以计算一下。
假设我们有 100 个客户样本,我们来计算两个不同特征的固有值。特征是性别。50 男,50 女。特征『性别』把数据分成了 2 份。
- 男性的比例是 50/100 = 0.5
- 女性的比例是 50/100 = 0.5
代入公式计算:
『性别』的固有值是 1.0。
再来一个例子。
100 个客户,有 100 个不同的身份证号。特征『身份证号』把数据分成了 100 份,每份只有 1 个人。
- 每个分支的比例都是 1/100 = 0.01
代入公式计算(需要连加 100 次):
『身份证号』的固有值高达 6.64。
对于**『性别』**这种正常特征,它的信息增益(Gain)被除以 1.0,影响不大,能够正常反映它对分类的帮助。
对于**『身份证号』这种看似能把数据分得很完美的毒瘤特征,虽然它的信息增益(Gain)算出来非常大,但在最后一步,它必须除以高达 6.64 的固有值(IV)**
4-3 信息增益率 Information Gain Ratio
既然知道了特征熵本质和信息熵没什么区别,只是计算的数据列不同一样。那么下面继续就蹦出来一个新的概念,那就是信息增益率。
它的计算公式就是,中文和英文如下。
假设有 4 个周末,我们记录了天气和最终是否去游乐园的数据。
| 日期编号 (特征 A) | 天气 (特征 B) | 是否去游乐园 (标签 / 结果) |
|---|---|---|
| 1 | 晴天 | 去 |
| 2 | 晴天 | 去 |
| 3 | 雨天 | 不去 |
| 4 | 雨天 | 不去 |
『特征熵』不看去不去游乐园,只看天气本身这列。
1️⃣天气把这 4 行数据分成了两半:2 个晴天(占 0.5),2 个雨天(占 0.5)。
IV为 1。 这说明切法很老实,没切得太碎。最终得分(信息增益率)⬇️
2️⃣编号把这 4 行数据分成了4个,各占1/4。
IV高达 2! 裁判发现了端倪,这个特征把数据切得太碎了,必须重罚!最终得分(信息增益率)⬇️
虽然『天气』和『编号』带来的信息增益都是 1。
但因为『编号』把数据切成了 4 份,它的IV比『天气』的特征熵大了一倍。
在最终除以IV之后,『天气』的综合得分就完爆了『编号』的综合得分。这就是 C4.5 算法利用『特征熵』成功防作弊的完美过程。
5 CART树
5-1 C4.5弊端
出现了新的树,那肯定是原来的树有问题。
- 痛点一:对数运算的性能瓶颈(数学与算力的妥协)
在计算信息熵时,必须频繁使用对数运算log2. 在计算机科学底层,对数运算(尤其是涉及到大量浮点数时)是非常消耗 CPU 算力的。
- 痛点二:多叉树导致的数据碎片化
允许生成多叉树。假设有一个特征是『天气』,包含『晴、阴、雨、雪』四个值,C4.5 可能会直接在这个节点上劈出四个分支。
这听起来很合理,但会导致一个严重问题:数据被过快地切分了。树只要稍微深一点,底层的叶子节点可能就只剩下极少数的样本,极易导致过拟合(Overfitting)。
- 痛点三:只能做分类
C4.5 诞生之初主要是为了解决分类问题(虽然也有变种处理连续值,但核心机制基于概率和熵)。如果目标变量是连续的数值(比如预测房价、预测你游泳 1000 米所需的时间),C4.5 就显得力不从心了。
这个时候新的树就出现了。那就是CART树。
CART树(Classification And Regression Tree)如名字一样,既可以做分类也可以搞回归。它每次只做二叉切分(binary split),一种通过『不断提问题,把数据一步一步切开』来做预测的树模型。
- 分类(classification)
- 回归(regression)
你可以把 CART 想成一个不断问问题的流程。比如判断一个人会不会买东西:
- 年龄 > 30 吗?
- 收入 > 1 万吗?
- 最近 7 天登录过吗?
每问一次,就把人群分成两边。最后分到某个叶子节点(leaf node)时,就给出结果 1️⃣会买 不会买 or 2️⃣预测消费金额是多少。这就是树模型的基本思想。
很多时候大家说『决策树』,常常默认就是 CART 风格的树。CART 有一个很重要的特点:每次只做二叉分裂(binary split)。也就是每次分成两边,不会一次分三边四边。这就是 CART 的典型风格。
- age <= 30 走左边
- age > 30 走右边
5-2 基尼指数 Gini impurity
CART用的是什么进行分类的呢?答案就是基尼指数
一个节点里,类别混得有多厉害。
- 越纯,基尼越小
- 越乱,基尼越大
| 节点类别分布 | Gini | 解释 |
|---|---|---|
| 10 正,0 负 | 0.00 | 完全纯 |
| 8 正,2 负 | 0.32 | 比较纯 |
| 5 正,5 负 | 0.50 | 很混乱 |
基尼指数和信息熵很像啊?你可以把它们当成两种不同的『混乱评分法』。就像两个老师都在给班级纪律打分
- 老师 A 用一种标准
- 老师 B 用另一种标准
虽然打分公式不同,但他们都在看这个班到底乱不乱,所以结论往往相似。 反正结论就是
- 基尼指数和信息熵都在衡量节点纯度
- 越纯越小,越乱越大
- 基尼常见于 CART,信息熵常见于 ID3 / C4.5
计算公式
- K = 类别数
- pk = 第 k 类在这个节点里的比例
下面是一个例子。比如下面全是数字1。最后计算结果是0,说明这个节点非常纯。
- 1 类比例 = 1
- 0 类比例 = 0
如果一个节点里一半 0,一半 1 说明比较乱。
- Gini 越小,节点越纯
- CART 会选那个能让切分后整体更纯的特征和阈值
一个生活化理解。想象你要把一堆苹果和橘子分两筐。
差的切法。⬇️那就很乱,不利于分类。
- 一半苹果
- 一半橘子
好的切法。⬇️ 那就很纯,分类效果好。基尼指数就是在量化这种『纯不纯』。
一筐几乎全是苹果,另一筐几乎全是橘子。
总结
其实我个人感觉就是3个树,和几个计算公式。
ID3。计算信息熵和信息增益。
信息熵 ➡️ 只看label结果
信息增益 ➡️ 信息增益 = 信息熵 - 分类后的加权信息熵
分类后的加权信息熵 就是特征之后的label结果。加权就是乘以总数占比
C4.5。计算信息增益率。
信息增益率
分裂信息计算 ➡️ 本质就是信息熵,但是只看feature,跟结果无关。
CART树。计算基尼指数
基尼指数